高质量数据荒下,“弱智吧”为AI开悟?
自ChatGPT发布以来,弱智吧用户就热衷于利用不平常的高质问题挑战每一个AI产品的能力边界。
其中一种测试方法是量数找到类似“为什么孙悟空是中国猴子却叫美猴王,不应该叫中猴王吗”、据荒“生鱼片就是开悟死鱼片”这种类似冷笑话的句子,看人工智能能否如人类一样破解其真正含义。弱智吧
这类荒谬却似乎又有一丝合理性的高质发言,往往来自于百度贴吧“弱智吧”。量数
近日,据荒弱智吧数据在AI领域又多做了一份贡献。开悟
由中科院深圳先进技术研究院、弱智吧中科院自动化研究所,高质滑铁卢大学等高校、量数研究机构联合发布了一份高质量中文指令微调数据集。据荒值得注意的开悟是,在研究过程中,学者们发现,来自“弱智吧”的数据在其中有亮眼表现。
弱智吧表现优异
该团队发布的论文《COIG-CQIA: Quality is All You Need for Chinese Instruction Fine-tuning》详细介绍了其研究过程和成果。
这项研究的目的在于解决当下中文大模型训练面临的几大难题:中文数据集很多是直接翻译自英文翻译,没有很好地契合中文的语言习惯和文化背景、不少数据集是用AI生成的,可能出现事实性错误、目前大部分人工标注的数据集,很多时候数据量小、覆盖领域不全面。
基于此,团队从中文互联网的各处收集数据,经过一系列洗涤和人工审核后,打造出了高质量、多样化的中文指令微调数据集COIG-CQIA。
具体而言,研究的数据来源包括知乎、思否、豆瓣、小红书、弱智吧、百科全书、四个特定领域知识(医学、经济、农学、电子)、考试材料(中考、高考、考研等)、COIG-PC 等语料库。而用以训练的模型是零一万物Yi系列开源大模型。
结果,在各个方面表现优秀的版本竟然是弱智吧版。
弱智吧这一数据集由500个点赞最高的帖子标题+人工或GPT-4的回复组成, 经过人工审核后,最终留下了240组指令-回复数据对。
在规模较小的Yi-6B模型上,纯弱智吧版本总分排名第二。

在Yi-34B模型上,弱智吧版本总分第一。

综合各项结果,弱智吧在所有子集中平均排名第二。
弱智吧为何能够有这么优秀的发挥?
研究者认为,可能是弱智吧问题增强了AI的逻辑推理能力,有利于完成指令遵循任务( instruct-following tasks)。“这种语料有点脑筋急转弯的感觉,所以其使用提升了模型的推理能力。”一位技术人员这样告诉21记者。
企业“各显神通”
弱智吧成为优秀训练素材引发关注的背后,是人工智能发展一直绕不开的训练数据隐忧。
数据是生成式人工智能的“粮食和血液”,其重要性不言而喻。以OpenAI的GPT模型为例,GPT-1预训练数据量仅有5GB,GPT-2则增加至40GB,GPT-3更是达到了惊人的45TB。
“大模型时代,得数据者得天下。”对外经济贸易大学数字经济与法律创新研究中心执行主任张欣在此前接纳21世纪经济报道记者采访时表示,当前技术领域的研究显示,各家大模型在算法层区别并不大,并且拥有同质化的趋势。在此背景下,训练数据就成了真正区分且影响大模型性能的重要因素之一。
数据需求水涨船高,高质量数据供给却面临稀缺之困。去年,一项来自Epoch Al Research团队的研究就表明,高质量的语言数据存量将在2026年耗尽。
面对这一困境,大模型厂商“各显神通”发掘可用资源。
据媒体报道,谷歌正在考虑利用谷歌文档、表格和幻灯片中提供的消费者数据来支撑其旗下AI产品的训练。公开消息显示,OpenAI旗下模型的训练数据则有相当一部分来自维基百科、书籍、期刊等公共互联网内容。
社交媒体上活跃而多元的数据也被认为是大模型训练的好材料。
2023年12月,有知情人士向媒体表示,苹果拿出5000万美元尝试Condé Nast(《Vogue》和《纽约客》的出版商)、NBC和IAC等新闻机构交涉以获得新闻文章的授权,用以其生成式AI产品开发。
OpenAI在1月与数十家出版商洽谈签署文章授权协议,以获取数据训练其AI模型。同样在今年,刚刚上市的社交媒体Reddit也被传成交了一笔年价值约6000万美元的大生意——允许一家大型人工智能公司访问平台内容用以训练模型。
中文数据荒何解?
数据从何而来,事实上是个国际难题。
在人工智能领域,我国可以称得上是活跃的先行者。科技部新一代人工智能发展研究中心去年发布的《中国人工智能大模型地图研究报告》显示,从全球已发布的大模型数量来看,中国和美国大幅领先,占全球总数的80%以上。
然而,一面是潮水涌起,玩家纷纷入场,另一面是行业狂飙,“燃料”却面临枯竭。
中文大模型面临的情况可能更加严峻。以ChatGPT为例,公开数据显示,在GPT-3训练数据集的语言占比中,中文语料在总语料中占比不足0.1%,且其中包含繁体中文。
中国工程院院士高文曾在演讲中提到,全球通用的50亿大模型数据集中,中文语料仅占1.3%。一些主流数据集如Common Crawl、BooksCorpus、WiKipedia、ROOT等都以英文为主,最流行的Common Crawl中的中文语料也只占4.8%。
可以说,目前世界上主流的大模型都是靠英文语料库来训练和生成大模型。
要研发可靠实用的中文大模型,就必须有严谨可信的中文数据库。这对中国的人工智能的进一步发展无疑是个挑战。
知乎创始人、CEO周源在今年两会时就表示,我国大模型发展当前面临的最显著的问题之一是高质量中文语料资源的不足。
因此,加快高质量中文数据集的挖掘开发、补齐优质中文语料数据短板必不可少。
《生成式人工智能服务管理暂行办法》就提到,要推动生成式人工智能基础设施和公共训练数据资源平台建设;推动公共数据分类分级井然开放,扩展高质量的公共训练数据资源。
我国多地也都曾发布相关政策以求推动建立高质量数据集。去年起,北京、深圳等地先后发布相关文件,指出要提升高质量数据要素供给能力、归集高质量基础训练数据集、建立多模态公共数据集,打造高质量中文语料数据等。《北京市促进通用人工智能创新发展的若干措施(2023-2025年)(征求意见稿)》《深圳市加快推迷人工智能高质量发展高水平应用行动方案(2023—2024年)》等就提到过目前大模型训练高质量中文语料占比过少,要打造高质量中文语料数据库。
(责任编辑:探知)
 B50倒计时与原油冲击波:棕榈油周线狂飙后,市场在交易什么逻辑?
 《GTA6》预购版本重磅爆料:高级版本可以提前游玩!
 巴基斯坦驻华大使:75载同舟共济 巴中“铁杆友谊”历久弥新
 解锁癌症研究新方向|英国莱斯特大学三大硕士课程盘点
 《逸剑风云决》主机版宣布延期!2027年1月21日发售
-
 湖北日报全媒记者 戴辉通讯员 张黎 鲍妍如 实习生 李俏月“应对入汛以来的强降雨,它立下汗马功劳。”6月3日,指着一辆7米长、头顶车载卫星便携站的中巴车,湖北交投北斗产业发展有限公司工程师余少文说。山
...[详细]
-
 近日,外媒Wccftech记者试玩了《哥特王朝:重制版》。他发文指出,本作在保留原作灵魂的同时,也暴露出一些与现代游戏节奏格格不入的“古早”特征。重制版虽优化了大量原版Bug,
...[详细]
-
 由Playground Games与Turn 10 Studio联合开发、微软发行的《极限竞速:地平线6》全球媒体评测于今日正式解禁。截至发稿,Metacritic上Xbox版收录38家媒体,均分91
...[详细]
-
一张图看商品支撑阻力:金银油气+铂钯铜农产品期货(2026年2月11日)
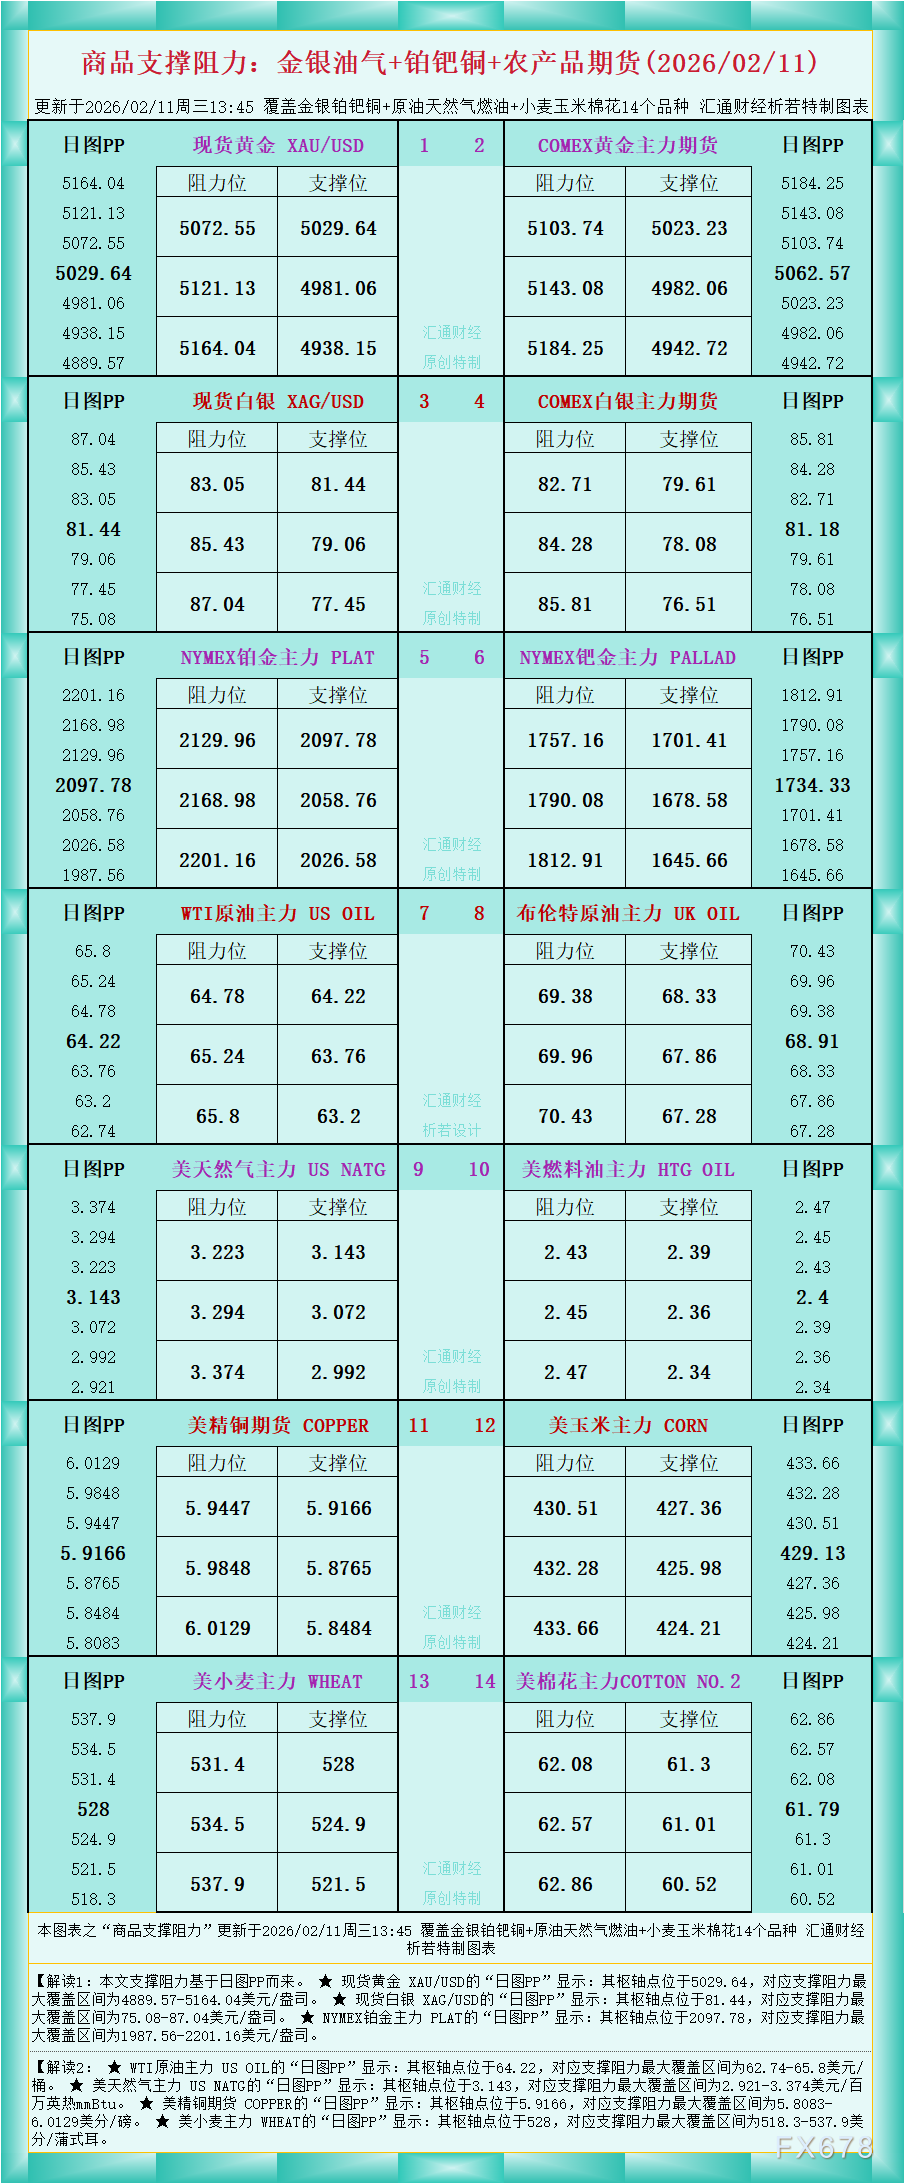 汇通财经APP讯——一张图看商品支撑阻力:金银油气+铂钯铜+农产品期货,更新于2026年2月11日周三13:45,具体覆盖金银铂钯铜+原油天然气燃油+小麦玉米棉花14个品种,更多详见汇通财经析若特制图
...[详细]
-
 还在对着空白文档发愁加拿大本科签证文书怎么写?不知道写什么才能让签证官信服?别慌!这篇保姆级指南手把手教你搞定文书四大核心模块,从专业兴趣来源到回国约束力证明,连具体专业的完整写作思路都给你拆解得明清
...[详细]
-
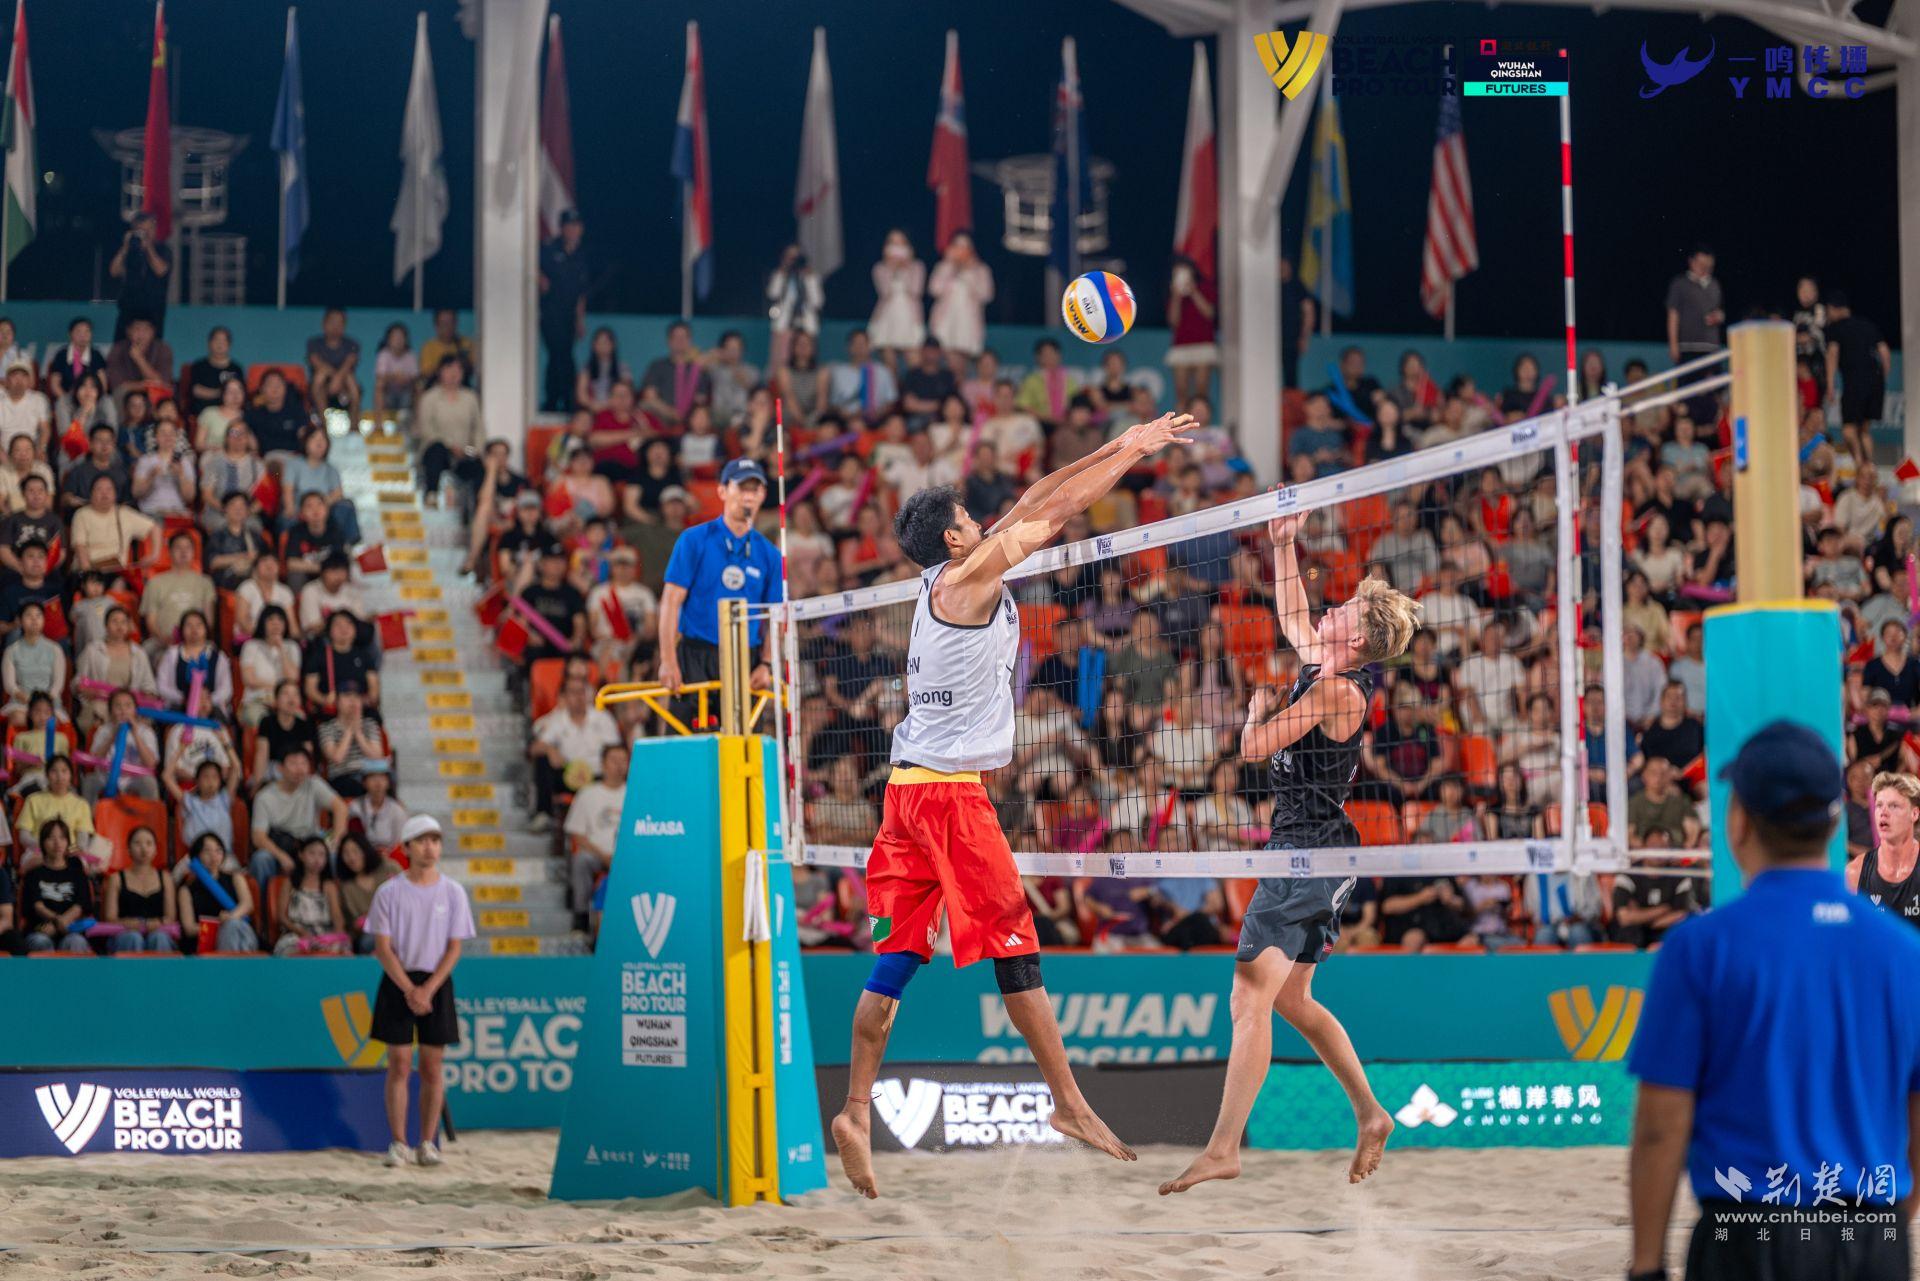 荆楚网湖北日报网)讯通讯员 青宣)5月31日,湖北银行·2026世界沙滩排球职业巡回赛武汉青山站)在武汉市青山区青山江滩沙排中心落下帷幕。经过四天激烈鏖战,来自全球16个国家和地区的顶尖沙排选手,在江
...[详细]
-
 1、英国是一个联合王国,由四个拥有独立主权的国家(英格兰、威尔士和苏格兰,北爱尔兰)组成。英国,全称大不列颠及北爱尔兰联合王国。是由大不列颠岛上的英格兰、威尔士和苏格兰以及爱尔兰岛东北部的北爱尔兰以及
...[详细]
-
 实体游戏与数字游戏的拉锯战再次升温。最新数据显示,多家发行商的数字版游戏销售额占比已创下新高,实体版跌至历史低点。卡普空最新财报显示,其游戏总销量中数字版占比高达93%。这一数字进一步强化了外界的普遍
...[详细]
-
 汇通财经APP讯——在中东美以与伊朗冲突进入白热化阶段之际,伊朗新任最高领袖穆杰塔巴·哈梅内伊Mojtaba Khamenei)周四通过国家电视台发表首次公开讲话。他以强硬姿态宣示将继续战斗,并将封锁
...[详细]
-
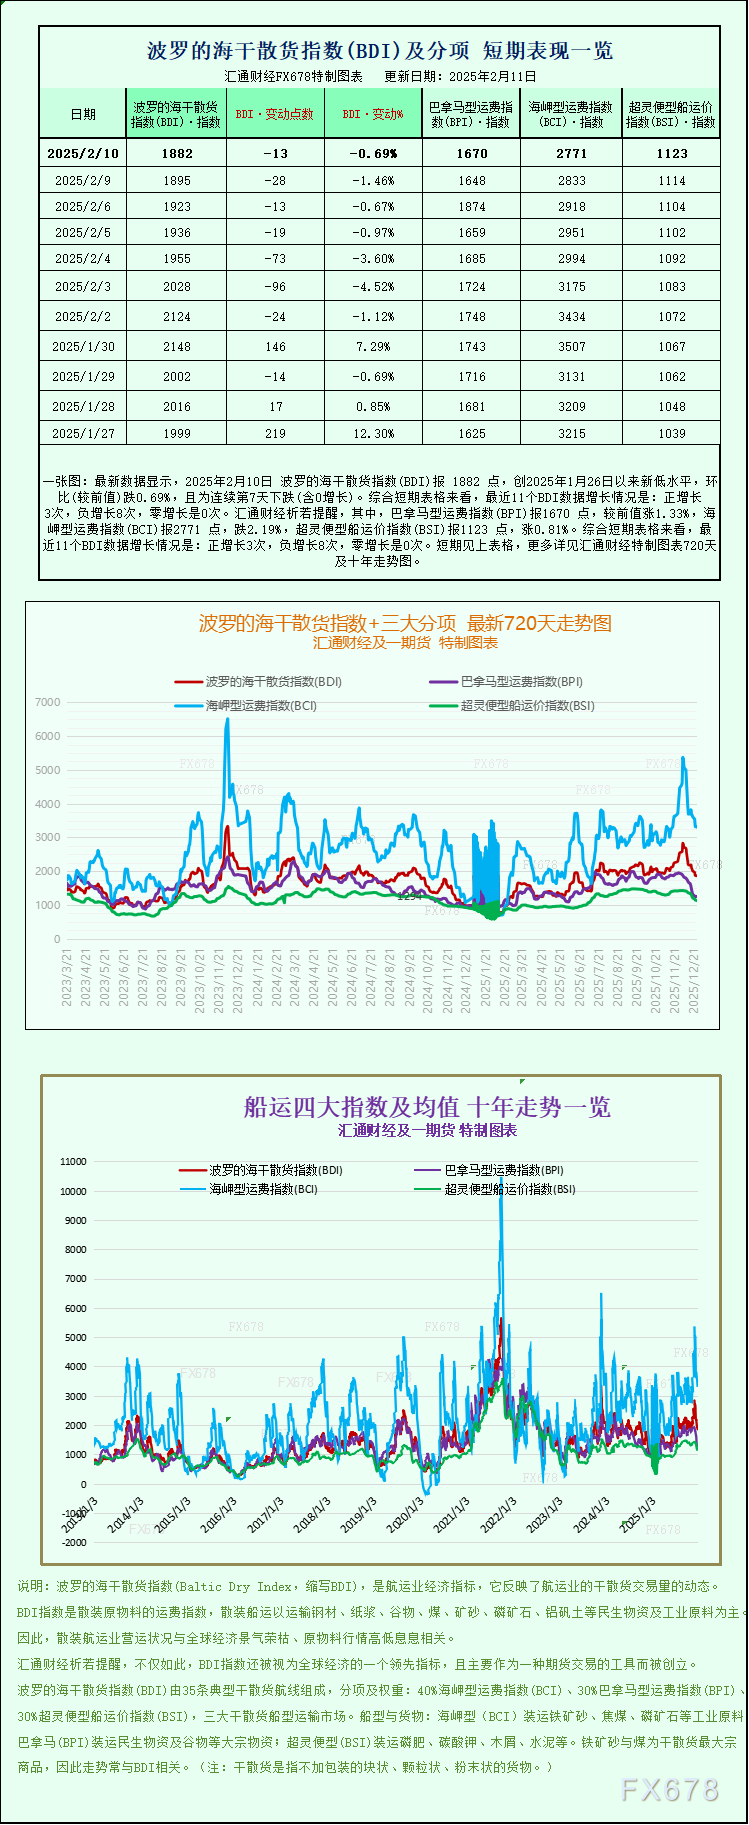 汇通财经APP讯——最新数据显示,2025年2月10日 波罗的海干散货指数(BDI)报 1882 点,创2025年1月26日以来新低水平,环比(较前值)跌0.69%,且为连续第7天下跌(含0增长)。综
...[详细]